
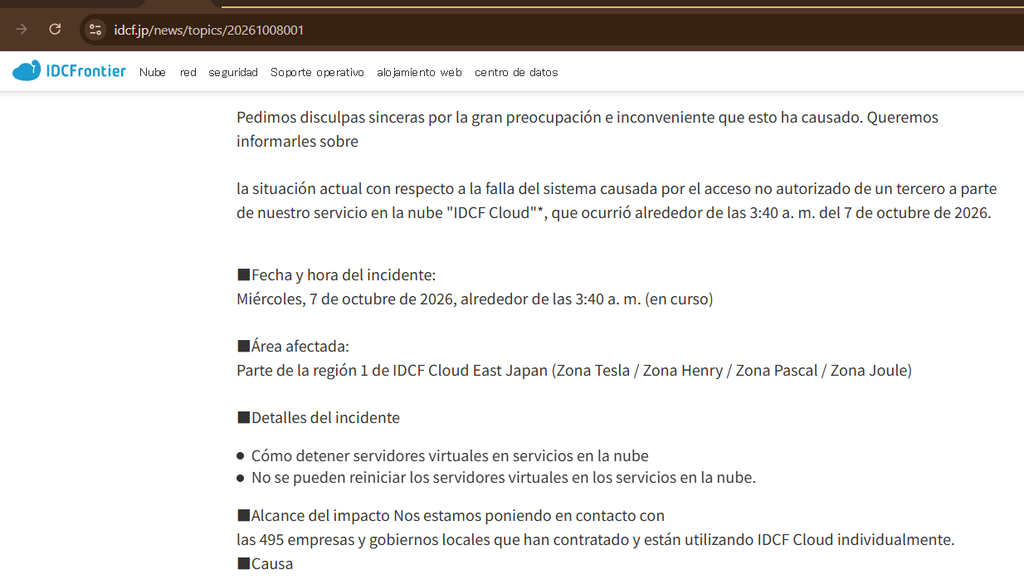
Un ataque de ransomware contra un proveedor japonés de infraestructura cloud interrumpió East Japan Region 1 y afectó a 495 empresas y gobiernos locales, según el tercer comunicado oficial del operador. El incidente comenzó el 7 de octubre de 2026 alrededor de las 03:40 JST.
CONFIRMADO: el operador aisló la región, suspendió sistemas y limitó temporalmente las consolas de administración. También informó que servidores virtuales detenidos en cuatro zonas no podían reiniciarse y que la recuperación dependería de copias mantenidas por cada cliente.
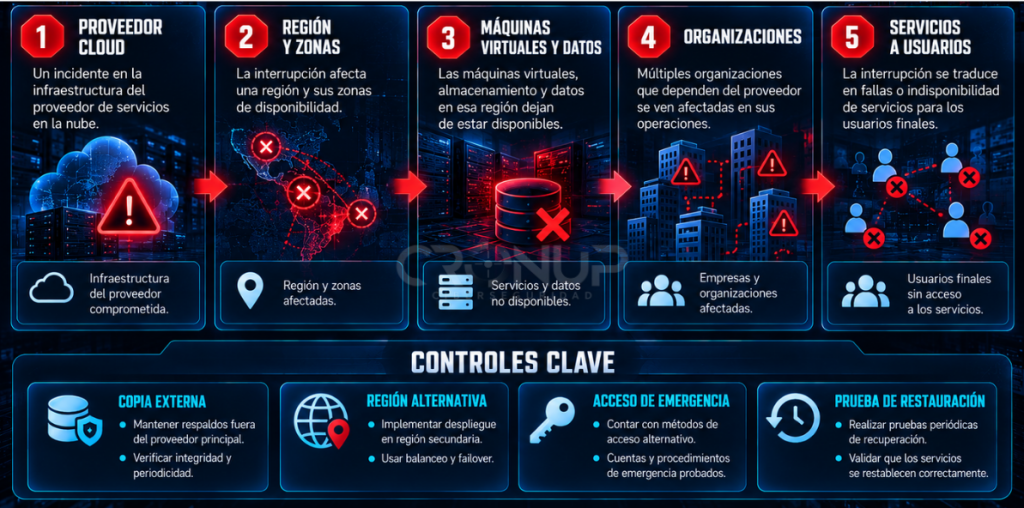
La consecuencia estratégica no se limita a un incidente de proveedor. Cuando el plano de administración también queda indisponible, cada cliente debe probar que conserva respaldos independientes, una ruta para reconstruir cargas y procedimientos que funcionen sin la consola principal.
Lectura rápida
Qué está confirmado y qué permanece abierto
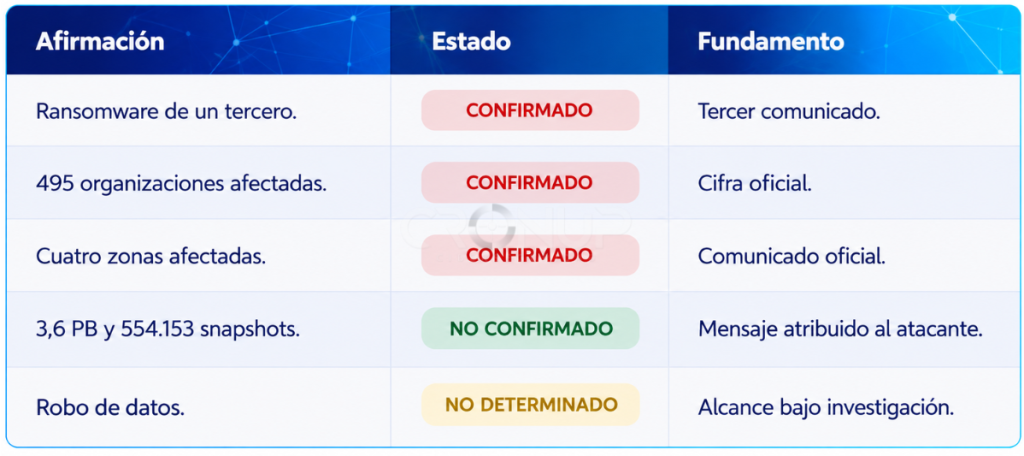
La evidencia disponible confirma una interrupción asociada a ransomware y un impacto sobre cuatro zonas de East Japan Region 1. Los nombres técnicos publicados para esas zonas fueron tesla, henry, pascal y joule. La cifra de 495 organizaciones afectadas proviene del comunicado del proveedor.
NO DETERMINADO: no se conoce públicamente el vector de acceso inicial, si existió exfiltración de datos, la identidad del grupo responsable o el alcance forense total. Tampoco existe evidencia que permita afirmar que todo el servicio cloud, todas las regiones o todos los clientes hayan quedado comprometidos.
Cronología inicial
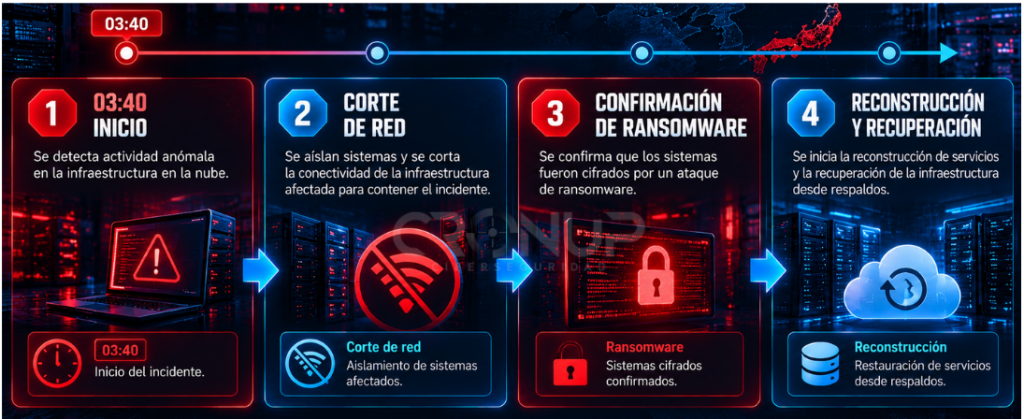
El 7 de octubre, cerca de las 03:40 JST, comenzó la interrupción en la región afectada. Durante el mismo día se identificó acceso no autorizado y posteriormente ransomware; el proveedor aisló la red y detuvo sistemas. El 8 de octubre, el tercer comunicado confirmó las 495 organizaciones y las cuatro zonas. El 9 de octubre se anunció una estructura reforzada para investigación, recuperación y coordinación.
La cronología sirve para evaluar decisiones, no para inferir una duración total de compromiso. Las fuentes no confirman una hora de detección del acceso ni el tiempo de permanencia del atacante.
El impacto operativo confirmado
Los servidores virtuales de las zonas afectadas fueron detenidos y no era posible reiniciarlos de forma convencional. La consola de administración se suspendió como medida de seguridad. Para un cliente, esa combinación limita la capacidad de encender, apagar, exportar o inspeccionar recursos mientras la respuesta está en curso.
El comunicado también indicó que extraer o restaurar datos desde las zonas afectadas sería difícil y que la ruta de recuperación contemplada era la restauración desde respaldos de los propios clientes. Esta evaluación hace visible un punto operativo: un snapshot dentro de la misma cuenta o plano de control no equivale necesariamente a una copia independiente.
Las cifras del atacante no son evidencia confirmada
Antes del bloqueo de las consolas, clientes observaron un mensaje atribuido al atacante que alegaba acceso en siete minutos, cifrado de 225 bases de datos equivalentes a 3,6 PB, afectación de 239 hipervisores, sellado de 16.000 discos virtuales y eliminación de 554.153 snapshots.
NO CONFIRMADO: esas cifras no fueron confirmadas por el proveedor ni acompañadas de evidencia forense pública. Pueden orientar preguntas de investigación, pero no deben comunicarse como dimensión comprobada del incidente.
Por qué el incidente supera al proveedor
Cuando el ransomware alcanza infraestructura compartida, el efecto se distribuye hacia organizaciones que no comparten red, sector ni operación. El punto común es la dependencia del proveedor. Un solo evento puede interrumpir aplicaciones, logística, portales ciudadanos y sistemas internos aun si cada cliente mantiene sus propios controles de endpoint.
La dependencia también condiciona la respuesta. Si la consola se deshabilita, el cliente necesita APIs alternativas, contactos de emergencia, inventarios actualizados y autorizaciones previas para ejecutar la continuidad. La resiliencia no se demuestra por tener cloud, sino por poder recuperar fuera de la ruta afectada.
Exposición y cómo saber si existe una condición equivalente
Priorice cargas críticas concentradas en una sola región o zona, respaldos almacenados en la misma cuenta o plataforma, snapshots como única estrategia de recuperación y dependencias de consola web sin acceso de emergencia documentado.
Revise infraestructura como código, credenciales de recuperación, contratos con el proveedor y las dependencias de terceros. Valide con una restauración real: fecha de la última copia externa, RPO medido, RTO medido, datos recuperados y responsables con acceso efectivo.
Qué buscar en detección y continuidad
No hay IOCs técnicos publicados. Las fuentes no entregan hashes, dominios, IPs, malware, grupo de ransomware ni rutas de intrusión verificables. Las cifras del mensaje atribuido al atacante tampoco constituyen indicadores de compromiso.
La búsqueda debe apoyarse en telemetría propia: accesos administrativos inusuales, creación o eliminación masiva de snapshots, cambios de políticas, actividad sobre hipervisores, cifrado acelerado, fallos de reinicio y acciones desde identidades privilegiadas fuera de horario. Estas son hipótesis de búsqueda, no reglas oficiales listas para producción.
Qué hacer a primera hora
1. Identificar servicios críticos por proveedor, cuenta, región y zona.
2. Probar una restauración desde una copia ubicada fuera del plano de control principal.
3. Separar respaldos inmutables y credenciales de recuperación en una cuenta o bóveda independiente.
4. Preparar reconstrucción en una región o proveedor alternativo mediante infraestructura como código.
5. Definir un runbook para operar cuando la consola del proveedor no esté disponible.
Cómo evitar caer
No interprete “está en la nube” como sinónimo de “está respaldado”. Guarde copias críticas en una cuenta o plataforma separada y pruebe la restauración.
Mantenga canales oficiales alternativos para confirmar el estado del servicio. Desconfíe de correos que aprovechen el incidente para pedir cambios de contraseña, pagos o descargas. Si un servicio esencial está caído, siga el procedimiento de continuidad y no improvise migraciones sin preservar evidencia.
Lectura ATRc®
ATRc® debe anticipar concentraciones de riesgo en proveedores, regiones, identidades y planos de control. Una organización puede no ser el objetivo directo y aun así quedar paralizada si su operación depende de infraestructura compartida afectada.
La métrica relevante es cuánto tarda la organización en reconstruir fuera del entorno indisponible. Medir recuperación real, independencia de respaldos y capacidad de operar sin consola convierte la continuidad cloud en una condición concreta de riesgo.
Conclusión estratégica
El incidente confirma que el ransomware puede convertir una dependencia cloud en una interrupción compartida por cientos de organizaciones. La pérdida de cómputo, administración y opciones normales de recuperación es tan relevante como el cifrado alegado.
La cifra confirmada es 495 organizaciones afectadas. Las cantidades atribuidas al atacante permanecen sin verificación. La respuesta defensiva debe centrarse en respaldos independientes, restauraciones probadas, reconstrucción automatizada, acceso de emergencia y dependencias mapeadas.
Indicadores y artefactos de comportamiento
No hay IOCs técnicos publicados. No se informaron hashes, dominios, IPs, malware, actor ni ruta de intrusión verificables.
Para búsqueda interna, mantenga como texto copiable: accesos administrativos inusuales, eliminación masiva de snapshots, cambios de políticas, actividad sobre hipervisores, cifrado acelerado, fallos de reinicio y acciones de identidades privilegiadas fuera de horario.

© 2026 CronUp Ciberseguridad. Todos los derechos reservados. Este contenido está protegido por la Ley Nº 17.336. Se permite su uso informativo citando la fuente y enlazando el artículo original. Su reproducción o uso sin atribución constituye infracción.





